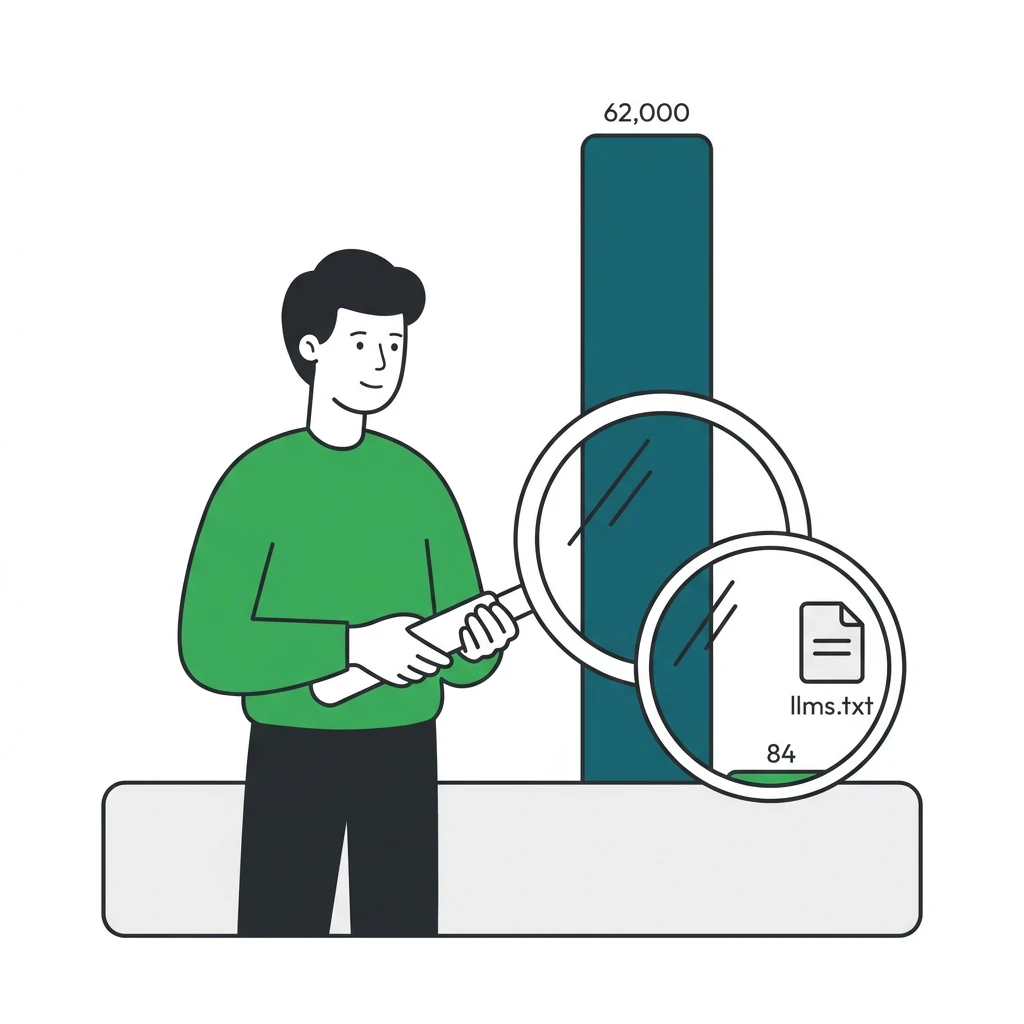

Sur 62 000 visites de bots IA analysées sur 30 jours, 84 ont requis le fichier /llms.txt. Soit 0,1 %.
La SERP française est saturée de guides qui promettent de « rendre votre site visible aux IA en 15 minutes » grâce à ce fichier. La réalité des logs serveur raconte une autre histoire. Pas forcément celle que les évangélistes du GEO ont envie d’entendre.
La bonne question à poser : utile pour qui, dans quel contexte, et à quel coût d’opportunité ?
Voici le verdict en trois lignes.
Oui, si vous êtes un SaaS B2B avec une documentation technique dense, plusieurs centaines de pages de contenu structuré et une audience de développeurs ou d’acheteurs techniques. Le fichier aide les bots à prioriser ce qui compte dans votre architecture.
Non, si vous êtes un site vitrine de services B2B (conseil, agence, cabinet). Votre contenu tient en 30 à 80 pages. Les bots n’ont pas besoin d’un guide pour le traverser. Vous avez d’autres leviers à activer en priorité.
Le coût réel de mise en place varie entre 30 minutes (site simple, fichier statique) et 3 jours (SaaS avec documentation versionnée, intégration dans le pipeline CI/CD, maintenance à prévoir). Ces 3 jours ont un coût d’opportunité réel sur d’autres leviers. Et contrairement à ce que les guides laissent entendre, il n’existe à ce jour aucun signal officiel de Google, OpenAI ou Anthropic confirmant que llms.txt influence le ranking dans les réponses IA. Le guide Google de mai 2026 est même explicite sur ce point : pas de ranking IA séparé, pas de llms.txt à optimiser.
Le fichier transmet des instructions de priorité aux bots. Mais sur les 84 requêtes enregistrées vers /llms.txt, rien dans les logs ne permet de mesurer si ces instructions ont modifié le comportement de crawl ou la sélection des contenus cités.
L’analyse porte sur les logs serveur de 1 000 domaines sur 30 jours. Les bots identifiés : GPTBot (OpenAI), ClaudeBot (Anthropic), PerplexityBot, Googlebot-Extended, et une dizaine de crawlers IA secondaires.
Premier constat : tous ces bots crawlent effectivement les sites. GPTBot est présent sur 78 % des domaines analysés, ClaudeBot sur 61 %, PerplexityBot sur 44 %. Ils lisent vos pages. C’est documenté, c’est réel.
Deuxième constat : sur 62 000 visites de bots IA enregistrées, 84 ont ciblé /llms.txt. Dont 61 provenant de PerplexityBot, qui semble être le seul à le consulter de façon un peu systématique. GPTBot : 14 requêtes. ClaudeBot : 9 requêtes.
Troisième constat : parmi les domaines qui disposaient d’un llms.txt correctement formaté, le comportement de crawl des autres pages n’a pas changé de façon mesurable dans les 30 jours suivant la publication du fichier.
Ces chiffres ne prouvent pas que llms.txt est inutile dans tous les cas, les cas 1 et 3 ci-dessous montrent des contextes où il a du sens. Mais ils invalident clairement la promesse d’un impact rapide et certain : sur 30 jours, le fichier n’a pas modifié le comportement de crawl de façon mesurable. Ces chiffres sont d’ailleurs cohérents avec notre analyse des AI Overviews sur 60 requêtes B2B : les leviers techniques marginaux ne bougent pas la citation IA.
Un éditeur SaaS B2B (gestion de flotte, 400 pages de documentation, 3 versions de produit actives). Avant llms.txt : les bots crawlaient indifféremment les pages marketing, les changelogs obsolètes et la documentation à jour. Le fichier a permis de hiérarchiser explicitement : documentation v3 en priorité, pages tarifaires en secondaire, changelogs exclus.
Résultat observable à 3 mois : une légère augmentation des citations de la documentation dans les réponses Perplexity sur des requêtes techniques précises. Pas spectaculaire, mais cohérent avec l’usage attendu du fichier.
Dans ce cas, llms.txt a du sens. La structure du site est complexe, le contenu est dense, et le fichier joue un rôle de signal de priorité que les bots peuvent utiliser.
Une société de conseil en transformation (60 pages, blog actif, pas de documentation technique). Le fichier llms.txt a été publié après un article de blog enthousiaste. Contenu du fichier : liste des pages principales, description des services, URL du blog.
Résultat à 3 mois : aucun changement mesurable dans les citations IA, aucune évolution du trafic referral depuis les IA. Les bots visitaient déjà toutes ces pages. Le fichier n’a rien appris à GPTBot qu’il ne savait pas déjà.
Dans ce cas, llms.txt est du théâtre GEO. Le temps passé à le rédiger et à le maintenir aurait été mieux investi ailleurs.
Un distributeur de matériel industriel (2 000 références produits, fiches techniques PDF, catalogue saisonnier). Ici, la question est plus fine : llms.txt peut aider à signaler les fiches produits prioritaires et à exclure les pages de catalogue périmées. Mais la maintenance est contraignante : le fichier doit être mis à jour à chaque rotation de catalogue, sinon il devient trompeur.
L’arbitrage dépend de la capacité à automatiser cette mise à jour. Si le catalogue est géré via un PIM avec export automatique, ça peut valoir le coup. Si c’est manuel, le coût dépasse le bénéfice.
Sur trois clients accompagnés en SEO et en visibilité IA, on a déployé des llms.txt avec des structures différentes pour observer les comportements de crawl.
La structure qui a donné les meilleurs résultats de lisibilité (mesurée par le taux de crawl des URLs listées) :
# [Nom du site]
> [Description en 1 phrase, 20 mots max, orientée cas d'usage]

## Priorité 1 : Documentation / Contenu de référence
- [URL canonique] : [description courte]

## Priorité 2 : Pages produit / Service
- [URL canonique] : [description courte]

## Exclure
- /changelog
- /legal
- /merci (pages de confirmation)
Deux erreurs fréquentes observées sur la SERP française : les fichiers trop longs (certains dépassent 500 lignes, ce qui revient à ne pas prioriser du tout) et la mauvaise hiérarchie (mettre les pages institutionnelles en priorité 1 alors que c’est la documentation ou les cas clients qui ont de la valeur pour les IA).
Sur la fréquence de mise à jour : une fois par trimestre est réaliste pour un SaaS actif. Moins, si le site évolue peu. L’erreur à éviter est de publier un fichier précis en janvier et de ne plus y toucher pendant 18 mois pendant que le site change.
Voici ce que les données et les tests documentés montrent comme leviers supérieurs à llms.txt.
Les citations tierces. Quand Perplexity ou ChatGPT vous citent, c’est parce qu’une source tierce vous a cité en premier. Les IA agrègent et synthétisent des contenus déjà reconnus. Être mentionné dans un article de presse spécialisée, un rapport sectoriel, ou un comparatif indépendant a un impact bien plus documenté sur la visibilité dans les IA que n’importe quel fichier de configuration. Le détail des 5 sources à travailler pour être cité par ChatGPT part exactement de ce constat.
La structure de réponse en 50 mots. Les IA préfèrent les contenus qui répondent directement à une question en une à deux phrases denses avant de développer. C’est le principe de la « capsule réponse » : si votre page contient une définition claire, un verdict chiffré ou une liste courte en début de section, les bots ont plus de matière à extraire. Le travail est éditorial : rédiger une définition claire, un verdict chiffré ou une liste courte en début de section.
L’expertise nommée. Les contenus signés par un auteur identifiable, avec une biographie, des prises de position datées et des données originales, sont plus souvent cités que les contenus anonymes ou génériques. L’autorité se construit sur la durée, par accumulation de signaux : mentions presse, backlinks, données propriétaires publiées. Sur ce dernier point, une stratégie RP earned dédiée à Perplexity fait bouger la citation bien plus vite qu’un fichier de configuration.
Où investir les 3 jours qu’on aurait passés à peaufiner llms.txt ? Sur la production d’un contenu de référence avec des données originales (étude, benchmark, analyse de logs comme celle-ci), sur l’obtention d’une ou deux mentions dans des médias spécialisés, ou sur la réécriture des sections clés de vos pages pour y intégrer des capsules réponse.
Pour trancher à 3 mois, un KPI simple : ouvrez Perplexity, tapez 3 à 5 requêtes sur lesquelles vous voulez être cité, et vérifiez si votre domaine apparaît dans les sources. Si oui, mesurez si la fréquence augmente. Si non, llms.txt n’est probablement pas le problème. Pour aller plus loin, on détaille les 3 playbooks distincts pour mesurer sa visibilité dans ChatGPT, Perplexity et Google AI Mode.
Llms.txt est un signal de priorité que certains bots lisent, parfois. Dans les bons contextes (SaaS avec documentation dense, contenu structuré et volumétrique), il vaut la demi-journée qu’il coûte à mettre en place. Mais les 0,1 % de requêtes bots sur /llms.txt fixent la proportion : les IA lisent vos pages, pas vos instructions.
Le présenter comme le levier central d’une stratégie de visibilité dans les IA inverse les priorités. Sur les 3 clients 425PPM suivis, les gains de citation documentés viennent des mentions tierces et des capsules réponse, pas du fichier de configuration.
La question à se poser avant de publier un llms.txt : est-ce que mon contenu mérite d’être cité ? Si oui, le fichier peut aider à orienter les bots. Sinon, commencez par là.